 謝至恩
AI 應用正從一問一答的對話,走向能拆解任務、呼叫工具並持續執行的 AI 代理,運算基礎架構承受的壓力也隨之改變。 Google 宣布擴充第八代 TPU 產品陣容,新增專為安全與機密推論打造的 TPU 8tx,以及針對龐大脈絡視窗與最高單機櫃運算密度設計的 TPU 8i Max 。加上今年 4 月在 Google Cloud Next 發表的 TPU 8t 與 TPU 8i,Google 首度在同一年內推出四款 TPU 系統。

從對話走向代理 推論需求出現三項轉變
Google Cloud AI 與運算基礎架構副總裁暨總經理 Mark Lohmeyer 表示,過去幾年 AI 基礎架構的討論多聚焦於訓練能力更強的模型,如今推論端正從「問一個問題、得到一個回應」的對話階段,走向代理時代。 AI 代理接收請求後,會拆解成多個步驟,呼叫其他模型、存取內部工具、撰寫並執行程式碼、擷取資訊;原本單一的模型互動,在幕後可能變成數十、數百甚至數千次操作。
他指出三項根本轉變。一是從人類規模走向代理規模,單一使用者即可觸發大量並行活動,基礎架構需求隨之放大 10 倍、 100 倍甚至 1,000 倍;二是從記錄系統走向行動系統,AI 不只擷取與摘要資訊,更會與業務及資料系統互動、代替使用者執行工作,也帶來新的安全與合規要求;三是從簡單請求走向複雜的代理工作流程,需要存取大量檔案、文件、電子郵件等脈絡,並在長時間、多步驟的流程中維持這些資訊。
「現在的重點不只是擁有多少加速器,也在於能多快移動資料、多有效率地使用記憶體、如何降低延遲和成本,同時兼顧高度安全與合規。」Mark Lohmeyer 說。
TPU 8tx:機密運算與低延遲推論兼顧

一般而言,資料在儲存或透過網路傳輸時會加密,但電腦處理資料時必須先在記憶體中解密。 TPU 8tx 是第一款具備機密運算能力的 TPU,採用與 TPU 8t 相同的矽晶片,搭配客製化的 AMD CPU 主機,將安全機制內建於硬體層,讓敏感資料與模型權重即使在使用中,也能全程受到保護並維持隔離。
Mark Lohmeyer 說明,資料在網路連結、 TPU 晶片與記憶體中都維持加密,從 CPU 經 PCIe 到 TPU 8tx 晶片的整段路徑皆經過加密,系統也具備硬體層級的認證機制,用以確認系統與其宣稱的身分相符。保護對象包括模型權重、提示詞與企業資料,甚至能防止系統操作人員存取。除了在 Google Cloud 上提供,Google 也開始讓部分客戶在自有資料中心部署。
效能方面,TPU 8tx 採用原本為 TPU 8i 打造的低延遲 Boardfly 網路。 Mark Lohmeyer 指出,此架構可將晶片間最遠的通訊距離,也就是網路直徑縮減逾 50%,推論延遲時間較 TPU 8t 少一半。「核心價值在於,不必在兩者之間二選一。」他說,客戶可以同時取得機密運算帶來的安全與合規,以及低延遲的推論效能。命名中的「X」,同時代表新的網路拓樸與機密運算能力。
結合訓練等級的運算能力與高速推論網路,TPU 8tx 也適合小規模訓練。企業可在單一系統上以專屬資料微調模型、將大型模型蒸餾為較小模型,並透過強化學習訓練 AI 代理,過程中無須在不同叢集之間搬移敏感資料。目標客群包括受高度監管的產業與政府機構、有高度合規需求的企業,以及希望以加密保護模型權重的模型供應商。
TPU 8i Max:以雙晶片封裝突破記憶體高牆
Mark Lohmeyer 表示,AI 代理需要跨大量文件與不同程式碼庫工作,而且經常是多個代理同時進行,脈絡視窗持續擴大,對記憶體容量與頻寬都形成壓力。若不解決,企業只能減少代理可存取的脈絡而犧牲準確度,或是限制同時執行的工作負載數量、接受較慢的回應。
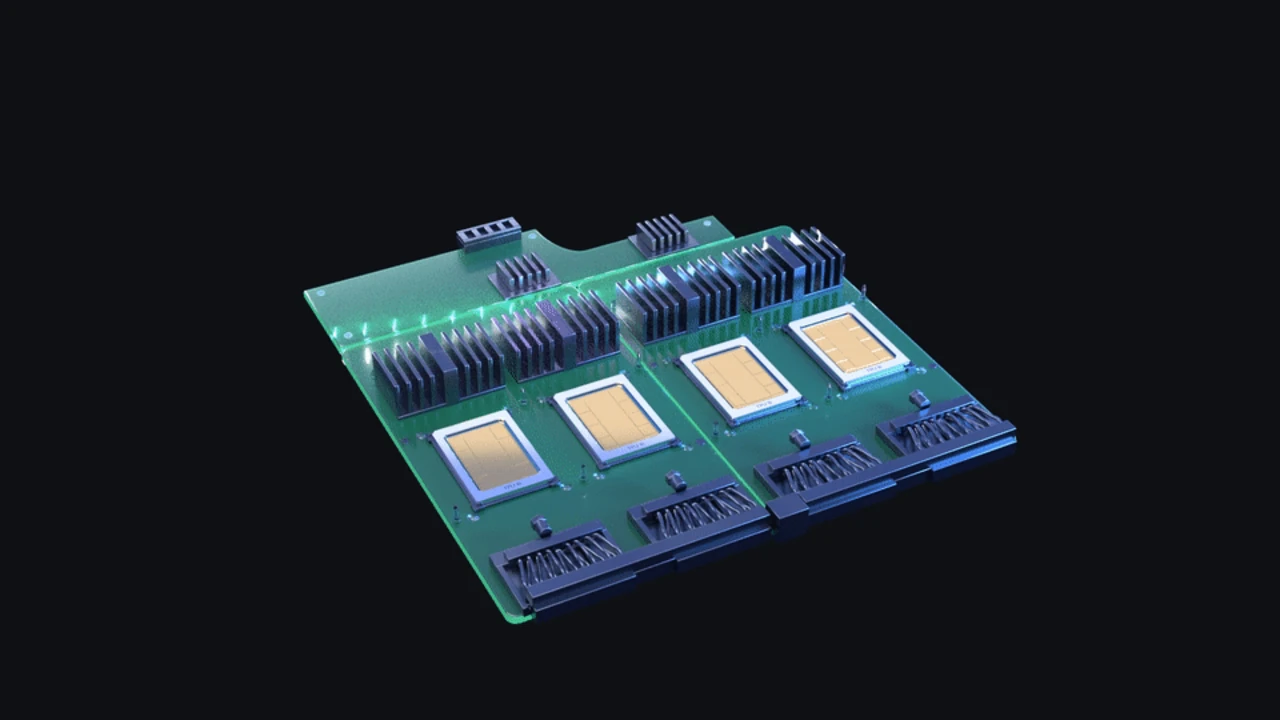
TPU 8i Max 將兩顆低延遲的 TPU 8i 晶片整合封裝在單一模組上,運算能力、 SRAM 與 HBM 頻寬都是 TPU 8i 的兩倍。 Mark Lohmeyer 指出,系統提供 384GB HBM 記憶體,比 TPU 8i 多 33%,有助於支援更大的脈絡視窗與 KV 快取;記憶體頻寬提高一倍至 17.2TB/s,晶片上 SRAM 也加倍至 768MB,讓常用資料更接近運算資源。
「基本上是在高速公路上增加車道,不一定讓每輛車跑得更快,但車道變多了。」他以此比喻 TPU 8i Max 提升整體處理量的方式。由於在相同機櫃空間中容納兩倍的矽晶片,資料中心每平方英尺與每瓦電力可部署的運算能力也隨之提升。他也提到,單一封裝的晶片層級功耗接近兩倍,效率提升主要展現在機櫃與系統層級。 TPU 8i Max 鎖定需要大量脈絡、同時執行多個代理並追求高處理量的工作負載。
一年推出四款系統 模組化設計加快交付
TPU 的推出節奏從過去兩年一款、一年一款,加快到一年兩款,今年更推出四款系統。 Google AI 與基礎架構副總裁暨技術長 Amin Vahdat 表示,設計一款新晶片需要耗費多年,打造系統則是將運算、網路與儲存資源整合在晶片周圍。 Google 在打造第一代 TPU 時,就將 TPU 架構設計為 AI 超級電腦 (AI Hypercomputer) 中的基礎建構模組,讓工程師能圍繞晶片快速調整封裝方式、高速記憶體、光學網路與安全防護機制,因此能在幾個月而非幾年內交付專用的超級電腦。
Mark Lohmeyer 也表示,Google 的硬體與基礎架構工程師,與 Google DeepMind 研究人員及 Search 、 YouTube 、 Photos 、 Gmail 等應用團隊密切合作,能及早觀察新的工作負載需求,並回饋到基礎架構設計中。
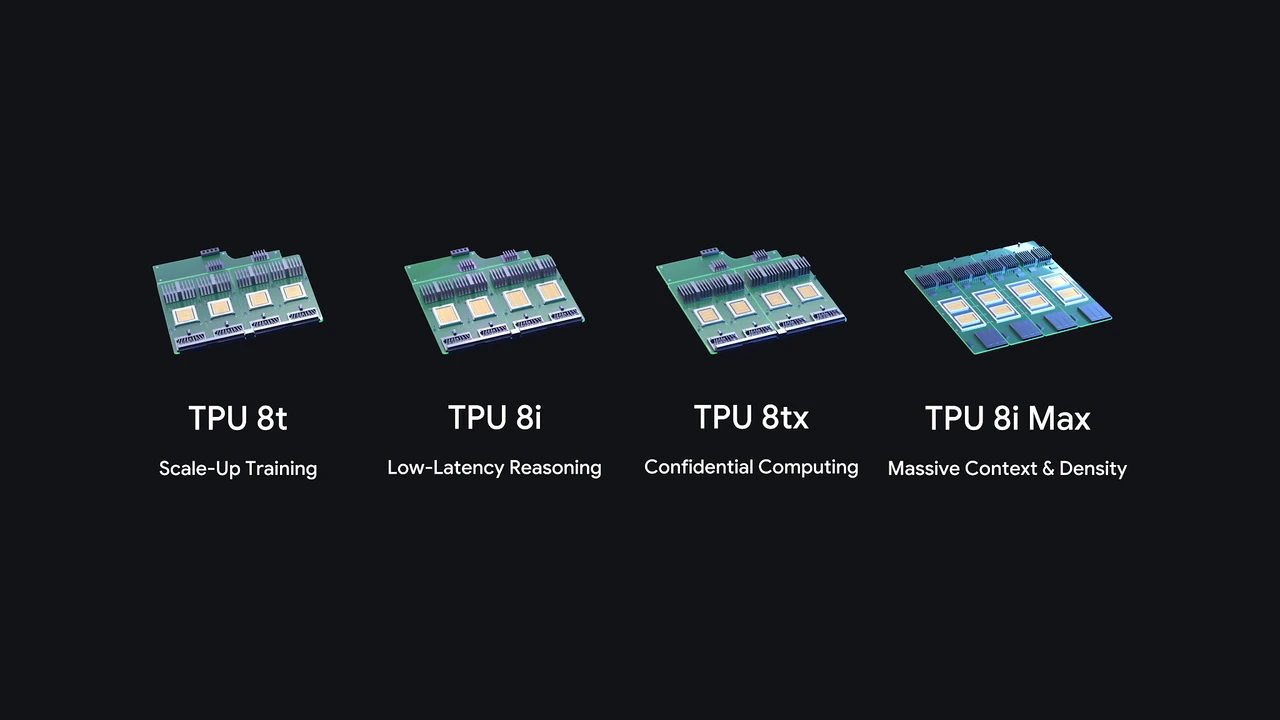
第八代 TPU 的四款系統各有分工:TPU 8t 用於大規模訓練,TPU 8i 用於低延遲推論,TPU 8tx 用於機密運算,TPU 8i Max 則用於處理龐大脈絡視窗與提供最高單機櫃運算密度。不過,Mark Lohmeyer 強調,各系統並非只能用於主要用途,已有客戶以 TPU 8i 同時執行推論、測試時推理與強化學習。
軟體降低 TPU 使用門檻
硬體之外,Google 也持續降低 TPU 的導入門檻。上個月開原的 TorchTPU,讓 PyTorch 程式碼與 Hugging Face 模型可在 TPU 上原生執行,並為 vLLM 與 SGLang 等開原推論引擎提供 TPU 後端支援。 Mark Lohmeyer 表示,TorchTPU 與 Meta 等業界夥伴合作開發,開發者只需修改一、兩行設定,即可沿用既有模型、程式碼與工作流程。
同時開放預覽的開原 TPU agent suite,可串接 Claude Code 、 Cursor 與 Google Antigravity 等程式編寫工具,在幾分鐘內自動完成 TPU 導入設定、診斷效能瓶頸,並以自然語言調校客製化核心。開原的 XLA Serving Engine 則讓使用者在 Python 中訓練模型,再於低延遲的 C++執行環境中,跨 TPU 、 GPU 與 CPU 提供模型服務。
針對 AI 代理在等待資料庫查詢、外部工具回應或人工回饋時經常暫停的特性,Agent Compute Engine 會在幾毫秒內自動暫停閒置的代理工作階段,並將工作記憶體移出晶片,以降低基礎架構營運成本。
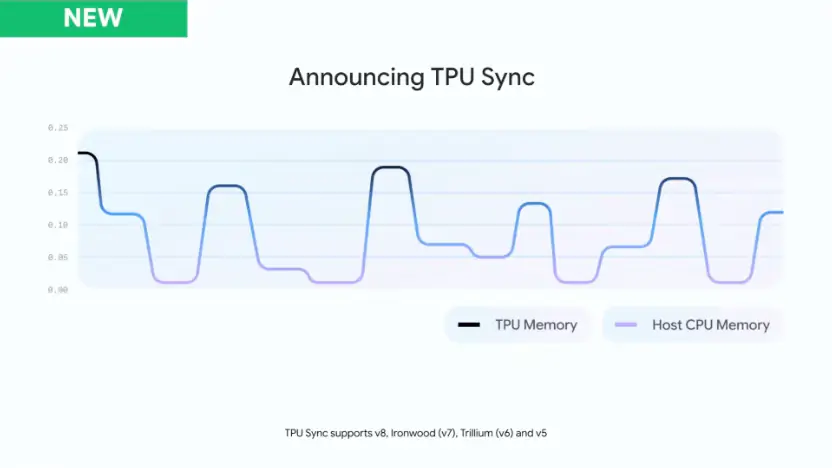
Google 也開原了專為 TPU 叢集打造的模型狀態層 TPU Sync,將晶片的 HBM 、主機的 DRAM 、共用儲存空間與資料中心網路整合為單一記憶體階層,能在幾毫秒內將 KV 快取分層移出晶片,跨分散的預填充與解碼節點串流傳輸脈絡,並同步強化學習權重,使 KV 傳輸延遲與第一個 Token 生成時間 (TTFT) 縮減 90% 以上。 Mark Lohmeyer 表示,TPU Sync 以軟體形式提供,除了 TPU 8 系列,也支援 TPU 7 、 TPU 6 與 TPU 5 。針對敏感資料,Google Cloud 產品經理 Jason Mondin 說明,TPU Sync 在晶片間移動記憶體時,透過 PCIe 連結加密,資料從硬體層級端到端維持完整加密。
在大規模部署方面,Cloud Pathways 已於 Google Kubernetes Engine(GKE) 上正式推出,讓使用者以單一控制器架構跨多個切片調度大規模 TPU 系統,進行預訓練、強化學習與多主機推論。已全面推出的 GKE 動態切片功能,則利用光路交換 (optical circuit switching, OCS) 技術,將實體硬體佈建與邏輯切片配置分開處理,可動態組裝更大的拓樸,或分割為獨立的較小工作負載。 Google 表示,作業啟動時間最多可縮短至原本的五分之一,故障復原速度最多提升至原本的 4.5 倍。
跨 TPU 與 GPU 調度 客戶陣容擴大
企業若同時使用 TPU 與 GPU,可透過 GKE 在兩種加速器之間統一管理。 Mark Lohmeyer 舉例,客戶可利用 GKE 的 Custom Compute Classes 設定策略,先在採用 NVIDIA GPU 的 A5X 執行個體上執行推論,容量用盡後再改由 TPU 8i 接手。
他也說明,不同 TPU 系統在資料中心是實體上各自獨立的叢集。 TPU 8t pod 透過 ICI 網路連接超過 9,000 顆晶片,再以 Google 自建的 Virgo 後端網路串接多個 pod,規模最多可達百萬顆 TPU;但透過 GKE 以服務形式提供後,客戶在邏輯層看到的是單一資源池。
TPU 目前擁有近 100 家客戶,涵蓋頂尖實驗室、交易機構、零售商與大學院校等。 Mark Lohmeyer 提到,Anthropic 、 Apple 、 Citadel 都是 TPU 客戶,Oracle Cloud 也宣布將以 TPU 提供服務。
Google 也開始運用 AI 設計下一代 AI 基礎架構。 Amin Vahdat 表示,Google 透過 Google DeepMind 的 AlphaChip 強化學習系統,並運用 Gemini 在幾小時而非幾週內完成晶片佈局,加快下一代 TPU 硬體的開發進程。